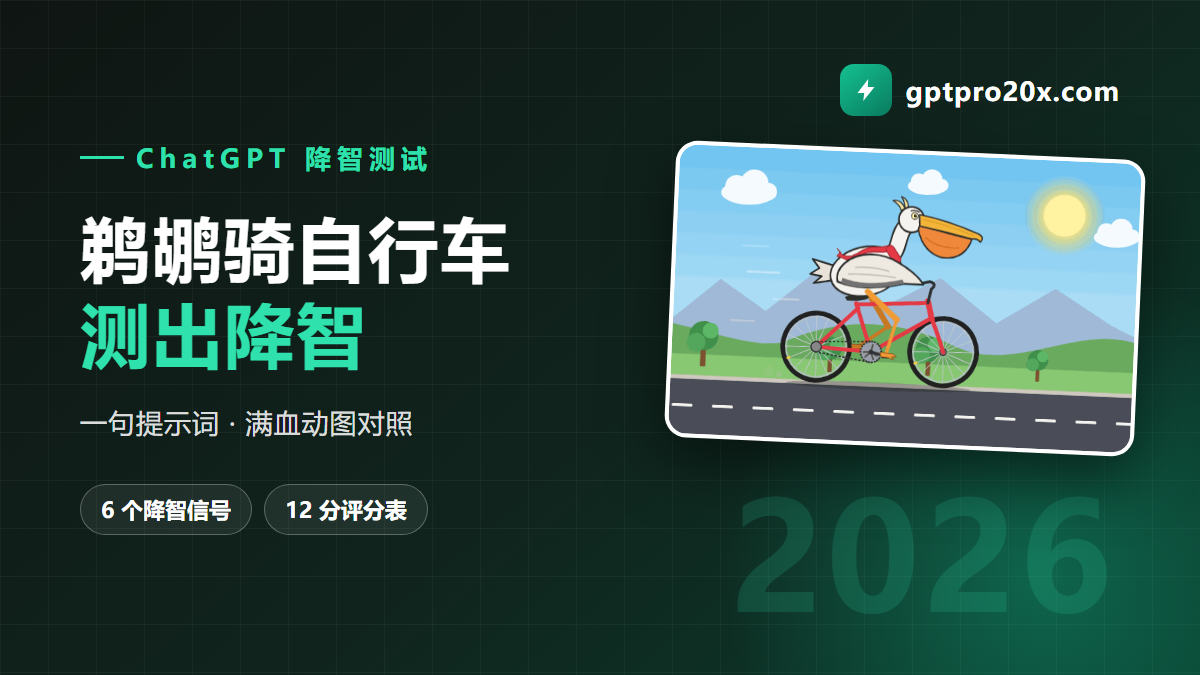
先说结论:怀疑 ChatGPT 降智,最快的自测办法是让它画一只「骑自行车的鹈鹕」动画。把下面这句提示词原样发过去,拿到的 HTML 用浏览器打开:满血状态下,你会看到一只有大喉囊的鹈鹕坐在车座上、脚踩踏板、车轮转动;降智时常见的是鸟悬在车上方、轮子不转、车架散架,或者只给半截代码。整个过程 1 分钟,不装插件,手机也能做,结果肉眼可见。
这是社区自测方法,不是 OpenAI 官方标准。一次结果说明不了问题,下文的评分表和「排除干扰」部分请一起看。
一、测试提示词和操作步骤
提示词原样复制,不要加别的要求:
创建一个HTML,内容是SVG绘制一个鹈鹕骑自行车的2D动画,你不需要任何测试- 开一个临时聊天:左上角模型名旁边打开「临时聊天」,避开记忆和自定义指令的影响。
- 手动选定模型:不要停在「自动」,选一个具体模型,以后每次测都用同一个。
- 粘贴提示词发送,等它把代码一次写完。
- 看效果:电脑上把代码存成
pelican.html,双击用浏览器打开;手机上如果回答里有「预览」按钮可以直接点开,没有就把代码发到电脑上看。
结尾那句「你不需要任何测试」是为了让模型直接交付成品,不去代码环境里反复运行调试,这样每次测试的耗时和产出更可比。
二、满血输出长什么样
下面两份都是账号正常时,用上面这句提示词一次生成、没有改动的结果:
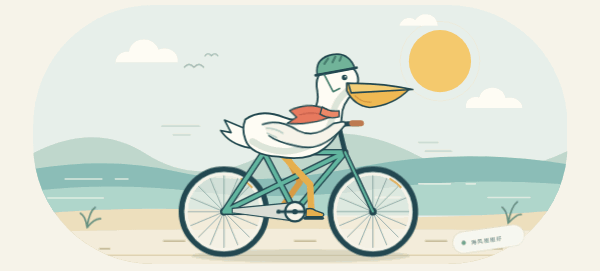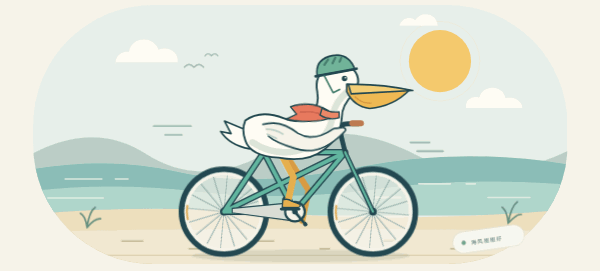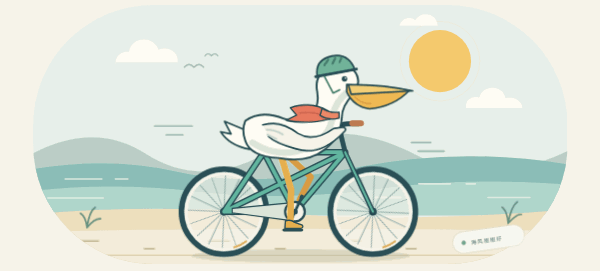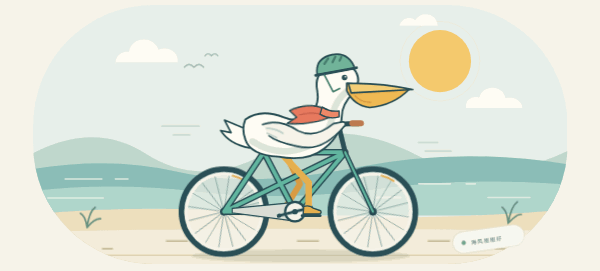
样例 A:海岸骑行,源码约 15KB
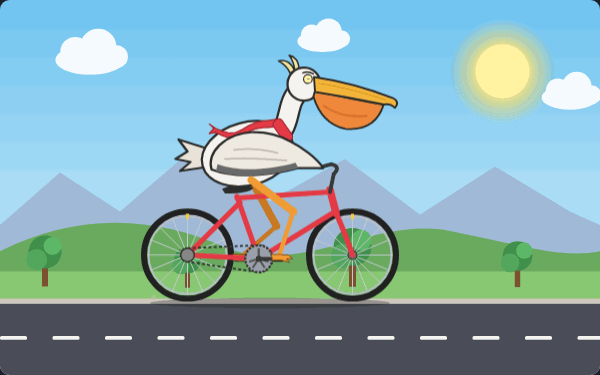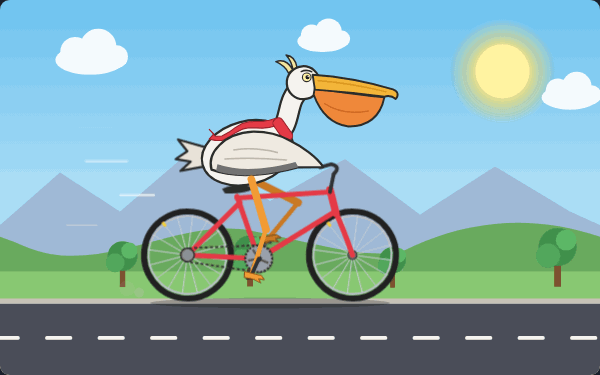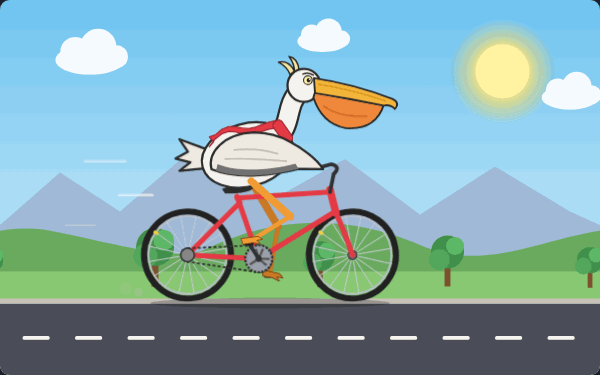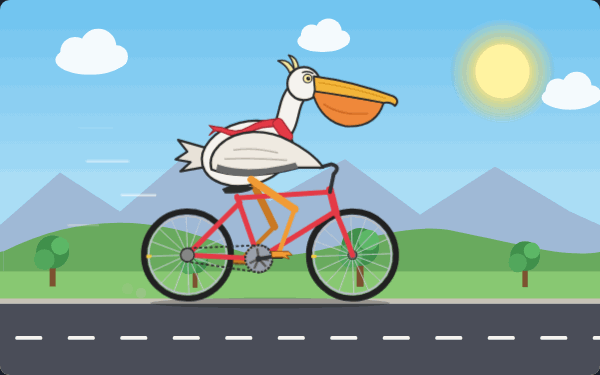
样例 B:公路骑行,源码约 17KB,自带暂停和调速按钮
动图是逐帧录制的循环演示,为了首尾衔接,录制时停住了云朵、微调了围巾和远景滚动的节奏,鹈鹕和自行车的动作没改。两份原版 HTML 源码放在 GitHub 开源仓库 chatgpt-jiangzhi-test,下载后双击就能看原版效果。
两份样例的共同点,就是满血状态的基本盘:
- 鹈鹕认得出来:长喙加下方的喉囊,不是一只普通的鸟。
- 骑乘关系对:身体落在车座上,脚在踏板上,翅膀搭在车把上。
- 自行车结构完整:两个轮子、三角车架、曲柄、链条,零件之间都连着。
- 真的在动:车轮旋转,腿随曲柄蹬踏,背景或路面在滚动。
- 有完成度:天空、云、太阳、地面一应俱全,甚至附带交互按钮。
三、降智输出的 6 个信号
- 鹈鹕不像鹈鹕:没有喉囊,喙很短,画出来像鸽子或鸭子。
- 人车分离:鸟悬在车上方,或者和车并排站着,脚碰不到踏板。
- 车散架:轮子和车架不相连,车架只有一两根线。
- 不动或假动:整张图只做左右平移,车轮不转、腿不蹬。
- 代码不完整:出现「此处省略」「其余部分类似」,或者打开就报错、一片空白。
- 明显偏短:正常样例都在 15KB 上下,只有两三 KB、几十行的,基本说明模型没认真做。
出现 1 条可能是运气,同时出现 3 条以上就值得怀疑了。
四、12 分评分表
6 个项目,每项 0–2 分,打完分对照下面的分档:
| 项目 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 能运行 | 打不开或报错 | 能打开但有元素缺失 | 直接打开就能播放 |
| 鹈鹕特征 | 看不出是鹈鹕 | 有长喙没喉囊 | 长喙、喉囊、比例都对 |
| 自行车结构 | 零件散开 | 有双轮但车架残缺 | 双轮、车架、曲柄、链条相连 |
| 骑乘关系 | 鸟和车分离 | 坐上去了但脚不在踏板 | 坐车座、踩踏板、翅膀握把 |
| 动画质量 | 静止或整体平移 | 车轮转但腿不动 | 车轮、蹬踏、背景都在动 |
| 完成度 | 只有主体 | 有简单背景 | 完整场景或带交互 |
- 10–12 分:状态正常。
- 6–9 分:可疑,隔一会儿开新的临时聊天再测一次。
- 0–5 分:大概率降智,连续两次都这样就要排查网络环境和账号。
分档是经验值。最有参考价值的用法是和自己以前的结果比:同一个账号、同一个模型,今天的分数比上周明显低,才说明出了问题。建议状态好的时候先测一次,把结果截图存档当基准。
五、下结论前先排除的 3 个干扰
- 模型选错了:选择器在「自动」时,简单问题可能被分给快速模型,画得差是正常的。
- 上下文污染:长对话、记忆、自定义指令都会影响输出,所以要在临时聊天里测。
- 随机波动:同样的提示词每次结果都不一样,至少测 2–3 次看整体水平。
另外,免费版在高峰期本来就可能被分配到更小的模型,免费版分数低不一定是降智,也不能和 Plus、Pro 的结果直接比。各档位能用哪些模型见 ChatGPT 各档位额度对照表。
六、画图测试和 PoW 风险值怎么对照
鹈鹕测试看的是输出质量,ChatGPT 降智检测工具读取的 PoW 风险值看的是网络环境和账号在 OpenAI 眼里有多可疑。两个结果放在一起,基本能判断问题出在哪:
| 鹈鹕测试 | PoW 风险值 | 判断 | 下一步 |
|---|---|---|---|
| 10 分以上 | 良好 / 优秀 | 状态正常 | 不用折腾,存个截图当基准 |
| 5 分以下 | 有风险 / 高危 | 环境导致的降智 | 先换干净稳定的网络节点,复测风险值回到良好再看 |
| 5 分以下 | 良好 / 优秀 | 多半不是风控 | 检查模型选择、换临时聊天,多测几次 |
| 10 分以上 | 有风险 / 高危 | 暂时没影响,但环境已被盯上 | 尽早换节点,避免频繁切换 IP |
PoW 检测要在电脑浏览器里做;手机上只能做画图测试和工具页里的 5 道探针题。
七、为什么偏偏是「鹈鹕骑自行车」
这个测试来自开发者 Simon Willison 的长期实验「pelican riding a bicycle」:每有新模型发布,他就让它用 SVG 画一只骑自行车的鹈鹕,用来横向比较模型能力。它好用有三个原因:
- 网上几乎没有现成答案,模型只能现场组合「鹈鹕长什么样」「自行车怎么构成」「怎么骑车」三类知识。
- 一眼就能判断好坏,不需要懂代码。
- 同时考空间推理和写代码,这两项恰好是降智时最先变差的。
这里在原版基础上加了「2D 动画」要求,多考一层时间维度:车轮转速、腿和曲柄是否同步。满血和降智的差距因此拉得更开。
八、测出降智之后怎么办
按从轻到重的顺序处理:退出重新登录、清缓存换浏览器;换一个干净稳定的网络节点,不要频繁切换 IP;不要和别人共用账号。每一步做完都用鹈鹕测试和风险值复测一次,确认恢复了再继续用。降智的成因和 6 级解决方案,详见 ChatGPT 降智原因与解决方案。
常见问题
ChatGPT 降智是什么意思?
用户圈的说法,指同一个模型在某些账号或网络环境下,回答明显变短、变浅、推理变差。OpenAI 没有官方承认,但社区普遍观察到它和网络环境、账号风控状态有关。
GPT代充、GPT充值之后会降智吗?
充值方式本身不决定模型质量,同一档位用的是同一个模型。充值后觉得「变笨」的,多半是登录时网络环境变了,或者模型选择器还停在「自动」。真正的风险在两种情况:要求你交出账号密码的,和给多人共享账号的,多人异地登录容易触发风控。开通方式对比见 国内怎么开通 ChatGPT Plus。
Plus 和 Pro 也会被降智吗?
会。风险评估看的是账号和访问环境,和订阅档位无关,付费用户一样适用这个测试。
这个测试能用来比较 Claude、Gemini 吗?
能,提示词通用。但不同模型之间比的是能力差距;判断是否降智,要拿同一个模型自己的历史结果来比。
测一次要多久?
发送到出结果一般 1 分钟左右,推理模型会久一些。测 2–3 次取整体水平,5 分钟内能下结论。